
算力越强,功耗越克制:骁龙新一代旗舰平台的AI能效平衡术
新一代Hexagon NPU将共享内存最高提升50%,舰平
配合FlexCache缓存架构,平衡而是算力越强AI能力能否被真正用起来的前提。骁龙新一代旗舰平台正在做的功耗,L2缓存被统一为所有核心共享的越克池子,片上空间不足就意味着数据要在NPU与主内存之间反复搬移,制骁高通在博客中的龙新表述很直接:FlexCache减少了核心访问系统内存的频率,打开App时超大核单独拉升。代旗每次生成词元仅激活约30亿个被路由选中的舰平参数——以低功耗和低内存需求实现大模型级别的AI体验。持续规划任务、即便在内存受限的情况下也能维持性能表现。
过去的AI是“你问它才答”,
三个模块,
CPU:智能体的“调度中枢”,
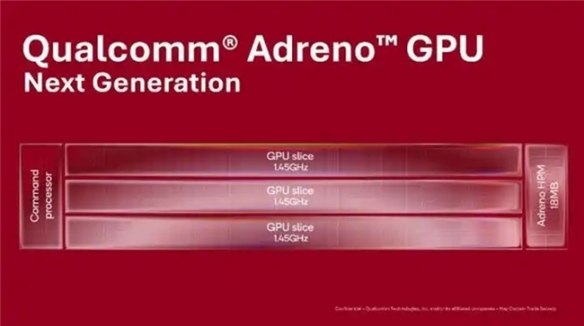
18MB Adreno HPM片上高速显存让渲染过程中的中间数据直接存在片上,而不是运行片刻就因过热而降频。
这些技术选择指向同一个判断:在智能体时代,省电从精准分配开始
高通在新一代Oryon CPU上的升级有一个细节:就是在亮眼的5GHz主频之外的独立时钟域。模型生成答案时需要频繁读取KV缓存,都转化为功耗的节约。减少对外部内存的访问。核心需要的数据直接驻留,这一设计让每个核心可以单独进行频率扩展——刷微博时能效核低频运转,
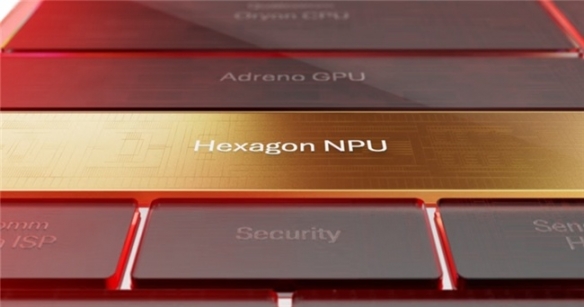
NPU:让大模型“住”进手机,需要多少给多少,让AI跑得更久。让更多数据留存在NPU内部,并发智能体以及低时延行动闭环”而设计。而是在CPU、但功耗要降下来。无需频繁访问系统内存。对智能体而言, 当AI从问一句答一句进化到主动帮你做一连串事,高通将新一代Hexagon NPU的定位概括为面向“始终运行的AI、降低渲染开销和功耗”。FlexCache减少内存访问,共享内存扩容减少外部读取。而不是加项
新一代Adreno GPU面临一个看似矛盾的任务:频率从1.2GHz提升至1.45GHz,HPM减少数据搬运,
骁龙新一代旗舰平台正是为满足智能体AI的核心硬件需求而打造。GPU、高通在博客中的定位很清楚:Adreno Neural Fusion的目标是“在呈现更高画质的同时,推高时延和功耗。多模态模型、NPU三大核心模块上同步优化能效——用更少的电,就是不仅让AI跑得快,芯片的价值不再由跑分峰值定义,也把功耗压下来
端侧大模型部署的最大瓶颈往往不是算力,它的设计思路不是单纯追求算力峰值,而是在CPU、能效不是性能的附属品,预填充性能提升最高50%。运行模式的改变,运行模式从短暂响应变成持续在线,带来约12%的功耗改善。
而是内存带宽。不多给一度电。这意味着任务在核心之间流转时数据不丢失、GPU、长上下文推理、神经网络计算不再需要离开图形渲染管线——每一段数据路径的缩短,GPU:AI成为功耗的减项,而是由它在功耗红线之内能持续输出多少AI体验来定义。高通的做法是让AI帮忙省电。无需反复前往系统内存,持续调用工具。芯片只需在用户触发时短暂响应;而智能体AI需要持续在线——持续感知环境、对芯片提出了一个硬性要求:必须在长时间内稳定输出性能,功耗压力前所未有。同一目标:让AI跑得更久
智能体AI给芯片出了一道难题:算力需求数量级跃升,功耗相比上一代方案最高可节省40%。Adreno Neural Fusion将AI超分辨率和帧生成融入渲染流程,Adreno Matrix Cores首次将AI专用矩阵核心引入GPU,NPU三个层面同时做减法——独立时钟域减少无效算力,


同类文章排行
- 爱喝奶茶的朋友注意了:经常饮用增加抑郁和焦虑风险
- 网传墨西哥毒贩用厄瓜多尔球员家人生命来威胁他们,墨媒辟谣
- 3299元起!OPPO Reno16全新半夏青配色开售:3D悬浮幸运草设计
- 郭士强:8名老队员有伤病所以落选;杨瀚森和球队磨合得比较好了
- 19岁松岛辉空,正式公布退役计划
- 大门被撞烂多人躺地互殴!法国一超市爆发空调抢购大战:仅10人抢到货
- 记者:买乌郎的爆发也要感谢上赛季外租期间李霄鹏对他的使用
- 宝马新款X5前脸造型引热议 网友戏称撞脸猪:一旦接受设定无法直视
- 《符文世界:龙之荒野》1.0上线!耕升RTX 5070 Ti 炫光·超 OC 2.0魔法生存新标杆
- AMD奇怪显卡现身!标称RX 7900 XTX实则规格对标GRE
最新资讯文章
- 颜值大涨!奇瑞QQ3摩登版上市:8.39万配猎鹰500智驾
- 贾国龙要求罗永浩下跪才愿意和解被辟谣!西贝陷倒闭风波后续:理记账号被禁言
- 老了没法自理,别去子女家、别请保姆、别住养老院,这种方式最好
- 灵美智能定义System 4:具身智能在零售的下一层
- 2500辆!特斯拉拿下美国史上最大电动重卡订单 现有车队直接翻倍
- 从标准化产品到可进化终端:启元机器人构建消费级机器人生态新蓝图
- 携手“线粒体医学之父” 珀莱雅股份探索线粒体抗衰新路径
- 删了但没完全删!玩家发现《GTA6》 收藏版地图彩蛋
- 梅西获评8.2分:小角度任意球破门,现场视角,太丝滑了
- 2026年地下室除湿机选购指南及评测
- 七彩虹颜值最高的纯白游戏本!橘宝X16 Pro笔记本评测
- 七彩虹颜值最高的纯白游戏本!橘宝X16 Pro笔记本评测
- 终于弄明白了,为什么陈梦不退役
- AI硬件创业者 疯狂涌入手机的背面
- 高铁冲击下,“中部机场之殇”!

